Podstawy AI
Czym jest analiza sentymentu? Metody, zastosowania i ograniczenia

 Dodaj Unite.AI do preferowanych źródeł w Google
Analiza sentymentu szacuje język oceniający w tekście, transkrypcjach mowy lub innych treściach. System może klasyfikować polaryzację, taką jak pozytywna, negatywna lub neutralna; wykrywać opinie na poziomie aspektów; szacować intensywność; lub identyfikować stanowisko wobec konkretnego twierdzenia.
Cel musi być określony starannie. Sentyment nie jest tym samym co emocja, intencja, toksyczność, satysfakcja czy prawda. Pozytywne zdanie może opisować szkodliwe zdarzenie w sposób sarkastyczny, podczas gdy negatywna recenzja produktu może wciąż polecać go ogólnie.
Kluczowe wnioski
- Zdefiniuj jednostkę, cel, etykiety i kontekst przed zbieraniem przykładów.
- Leksykony są przejrzystymi bazami; modele nadzorowane i transformatory mogą uchwycić więcej kontekstu, ale potrzebują reprezentatywnych danych.
- Negacja, sarkazm, słownictwo domenowe, tekst wielojęzyczny i granice aspektów nadal stanowią trudność.
- Oceniaj per klasa, podgrupa, domena i okres czasu; uwzględnij przegląd ludzki w zastosowaniach o istotnych konsekwencjach.
Poziomy i cele
Analiza na poziomie dokumentu generuje jedną etykietę dla całego elementu. Analiza na poziomie zdania rozdziela wypowiedzi, natomiast analiza oparta na aspektach łączy sentyment z podmiotem lub atrybutem — na przykład pozytywny w odniesieniu do jakości obrazu, ale negatywny w odniesieniu do żywotności baterii.
Stanowisko pyta, czy mówca popiera określoną propozycję, co może różnić się od tonu emocjonalnego. Te rozróżnienia powinny być ustalone w przewodniku anotacji przed zastosowaniem metod klasyfikacji tekstu.
Leksykony, modele klasyczne i transformatory
Leksykon przypisuje słowom oceny i łączy je z regułami dotyczącymi negacji lub intensywności. Jest interpretowalny i tani, ale ma problemy z kontekstem. Klasyczne modele nadzorowane wykorzystują cechy słów lub n‑gramów, natomiast transformatory uczą się reprezentacji kontekstowych i mogą być dostrajane.
Promptowanie w trybie few-shot może być wygodne, ale wyniki zależą od przykładów i sformułowań. Porównuj każde złożone podejście z bazą i używaj uczenia few-shot wyłącznie z odrębnym, wersjonowanym zestawem oceny.
Wyzwania związane z danymi i językiem
Etykiety mogą odzwierciedlać perspektywę anotatora, a nie obiektywny fakt. Przesunięcie domeny jest poważne: „nieprzewidywalny” może być pochwałą dla filmu i krytyką dla pojazdu. Przełączanie kodów, dialekt, emotikony, cytowane wypowiedzi i ironia komplikują sygnały na poziomie tokenów.
Świadomie równoważ klasy i zapobiegaj wyciekowi powiązanych autorów, produktów lub konwersacji pomiędzy zestawami treningowymi i testowymi. Model, który zapamiętuje markę lub mówcę, może wydawać się dokładny, nie ucząc się rzeczywistego sentymentu.
Ewaluacja i odpowiedzialne użycie
Raportuj precyzję, recall, F1 oraz macierz pomyłek zamiast jedynie dokładności. Przeglądaj błędy według aspektu, długości, dialektu i czasu oraz kalibruj progi w zależności od kosztu operacyjnego każdego błędu.
Zagregowane trendy mogą wspierać badania lub triage, ale wnioskowanie o stanie jednostki lub podejmowanie decyzji dotyczących zatrudnienia, kredytowania, zdrowia czy policji zwiększa ryzyko. Zapewnij niepewność, kontekst źródła, kontrolę prywatności oraz przegląd ludzki.
Anotacja i budowa zbioru danych
Stwórz przewodnik anotacji zawierający jednostkę docelową, jednostkę analizy, definicje etykiet, obsługę mieszanek i neutralności, zasady cytowania, politykę sarkazmu oraz przykłady z danej dziedziny. Przeprowadź pilotaż z kilkoma anotatorami, oblicz zgodność, omów rozbieżności i zrewiduj zadanie przed skalowaniem etykiet.
Próbkowanie określa, czego model się nauczy. Strumień mediów społecznościowych może nadreprezentować bardzo aktywne konta; zgłoszenia wsparcia mogą pomijać zadowolonych klientów; oceny gwiazdkowe mogą nie odpowiadać treści recenzji. Zachowaj metadane źródła i czasu, szanuj warunki platformy i prywatność oraz utwórz zestaw testowy z populacji, w której będą podejmowane decyzje.
Wycieki etykiet mogą wystąpić poprzez oceny, emotikony wstawiane przez system zbierający, szablonowe podpisy lub nazwy produktów skorelowane z sentymentem. Usuń duplikaty prawie identycznych postów i grupuj konwersacje lub autorów, aby ich język nie pojawiał się po obu stronach podziału.
Wybory modelowania i kalibracja
Systemy leksykonowe sumują oceny słów i korygują je pod kątem negacji, intensyfikatorów, interpunkcji lub emotikonów. Dostarczają przydatną kontrolę poprawności i mogą być dostosowane przy użyciu terminów domenowych. Modele liniowe z cechami TF‑IDF pozostają konkurencyjne na niektórych zbiorach danych i ujawniają wpływowe n‑gramy.
Kontekstowe enkodery reprezentują słowa w zależności od otaczającego tekstu i mogą być dostrajane pod kątem polaryzacji lub aspektów. Długie dokumenty mogą wymagać modeli hierarchicznych, agregacji zdań lub wyszukiwania odpowiednich fragmentów. Podejścia wielojęzyczne mogą trenować jeden wspólny model, tłumaczyć na język pośredni lub utrzymywać lokalne modele; każde ma swoje zasięgi i kompromisy kulturowe.
Kalibracja prawdopodobieństwa ma znaczenie, gdy wyniki wyzwalają akcję. Wykresy niezawodności i oczekiwany błąd kalibracji pokazują, czy zgłoszone 0,8 zaufania odpowiada około 80% poprawności. Progi mogą tworzyć pasmo wstrzymania dla przeglądu ludzkiego, a oddzielne progi mogą być uzasadnione, gdy koszty błędów się różnią — nie po to, by ukrywać nierówną jakość.
Zastosowania i typowe błędne interpretacje
Zagregowany sentyment może pomóc w priorytetyzacji tematów, porównywaniu reakcji na kampanie lub kierowaniu pilnych wiadomości serwisowych. Analiza aspektów jest często bardziej użyteczna niż ogólna polaryzacja, ponieważ identyfikuje, o czym ludzie mówią. Analiza trendów wymaga stabilnego próbkowania i stałych definicji etykiet w czasie.
Nie utożsamiaj częstości negatywnych postów z opinią całej populacji. Zachowanie w publikowaniu, boty, moderacja, demografia platformy, kampanie i zapytania zbierające kształtują próbkę. Model sentymentu nie mierzy cichej populacji, a zmiana sformułowań może wyglądać jak zmiana nastawienia.
W przypadku decyzji indywidualnych, fałszywe etykiety mogą być stygmatyzujące i trudne do zakwestionowania. Unikaj używania sentymentu jako wskaźnika zaangażowania pracowników, zdrowia psychicznego, zdolności kredytowej, intencji czy oszustwa. Gdy ludzie są dotknięci, pokaż kontekst źródła, umożliw korektę i wymagaj decydenta ludzkiego z rzeczywistą swobodą.
Przykładowe zastosowanie: analiza sentymentu w opiniach klientów
Firma analizująca komentarze wsparcia powinna określić, czy potrzebuje sentymentu dokumentu, sentymentu aspektowego, emocji, pilności czy klasyfikacji problemu. „Dostawa była szybka, ale produkt się zepsuł” nie może być wiernie przedstawione jedną etykietą pozytywną lub negatywną. Stwórz przewodnik anotacji obejmujący cele, negację, sarkazm, mieszane wypowiedzi, cytowane wypowiedzi i przypadki nieznane, a następnie zmierz zgodność przed traktowaniem etykiet jako prawdy podstawowej.
Porównaj leksykon lub liniową bazę z dostrojonym enkoderem lub modelem językowym z promptem. Podziel dane według czasu lub klienta, aby zapobiec wyciekom prawie identycznych przykładów, i zachowaj proporcje klas. Raportuj precyzję, recall, F1, kalibrację oraz macierz pomyłek według języka, kanału, produktu i demograficznych wskaźników, ale tylko tam, gdzie jest to legalne i uzasadnione. Przeglądaj błędy o wysokim zaufaniu, ponieważ są one bardziej niebezpieczne w automatycznym kierowaniu niż niepewne wyniki, które są eskalowane.
Używaj sentymentu jako jednego sygnału do agregacji lub priorytetyzacji, nie jako niekwestionowanego miernika stanu osoby. Monitoruj słownictwo i dryf produktów, ponownie trenuj na zweryfikowanych przykładach i pozwól agentom korygować etykiety. Nigdy nie wyciągaj wniosków o chronionych cechach ani nie karz pracowników na podstawie niewalidowanych wyników sentymentu. W raportach dla kadry zarządzającej pokaż wielkość próby, niepewność, brakujące dane oraz tematy napędzające zmiany, aby zmienny wynik prowadził do analizy, a nie do uproszczonego wniosku.
Wdrożenie wielojęzyczne nie powinno zakładać, że tłumaczenie danych wejściowych zachowuje ton, negację, idiom lub konwencję kulturową. Zweryfikuj każdy obsługiwany język i wzorce mieszanych języków z recenzentami native speakerami oraz zapewnij wynik „nieznany”, gdy dowody są słabe. Adaptacja domenowa także ma znaczenie: słowa brzmiące negatywnie w codziennej rozmowie mogą być neutralnymi opisami technicznymi. Utrzymuj oddzielne progi lub modele tylko wtedy, gdy dowody operacyjne uzasadniają dodatkową złożoność i obciążenie zarządzania.
Lista kontrolna praktycznej implementacji
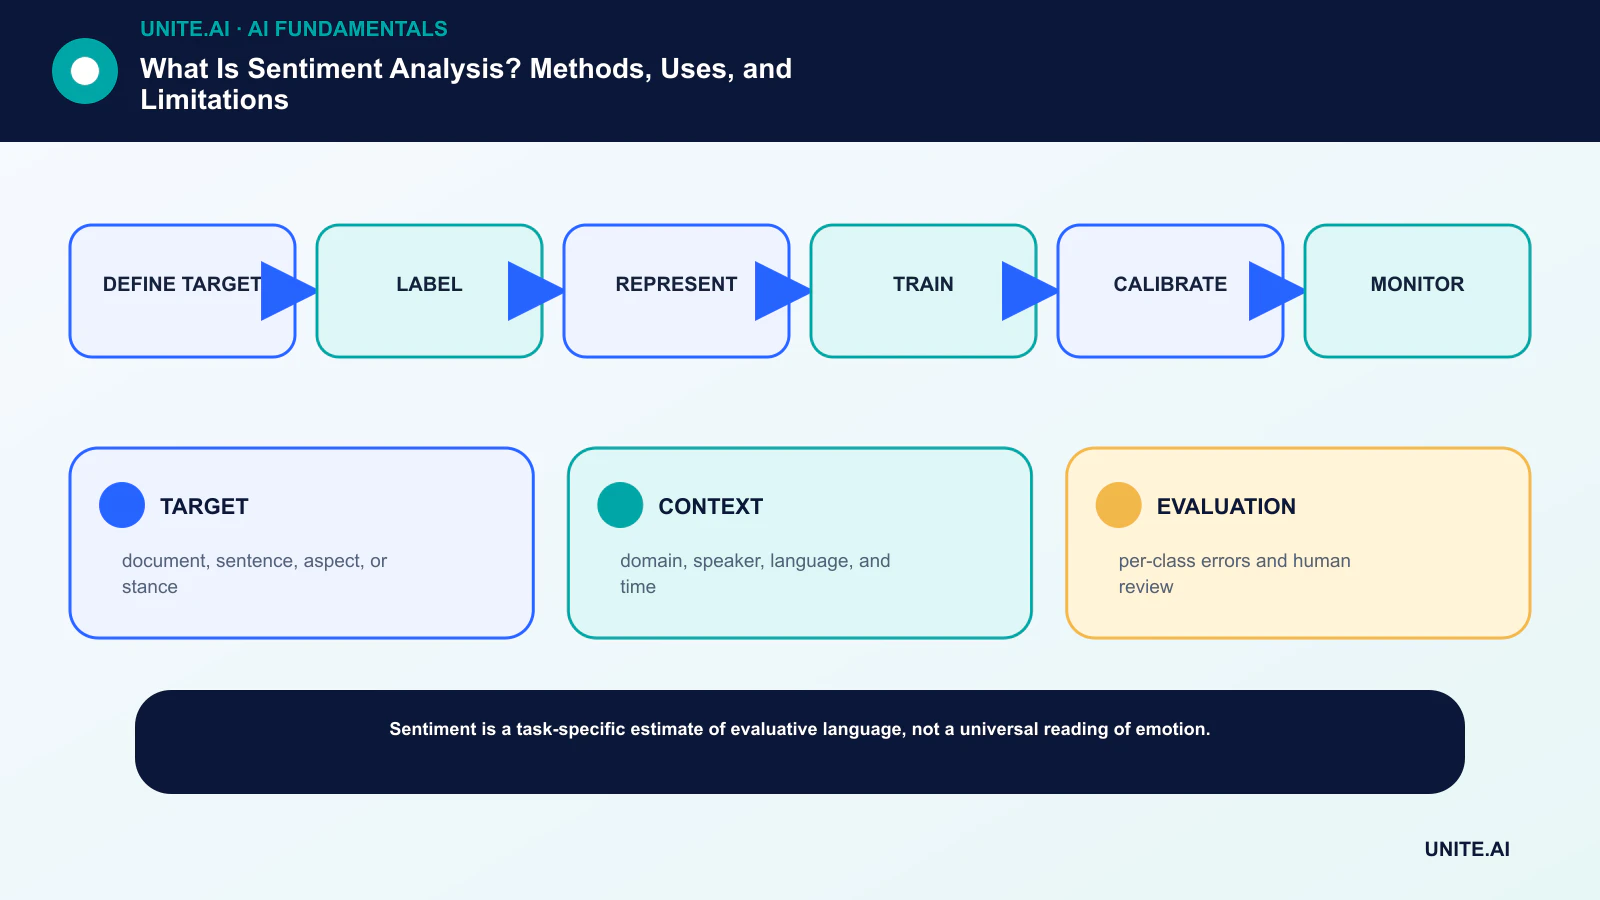
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: określ cel → etykietę → reprezentację → trening → kalibrację → monitorowanie. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustanów prostą bazę, ustal kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, przywrócenie i przegląd przed rozszerzeniem zakresu. Zapisz wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowany przegląd gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie rozważ decyzję po pojawieniu się danych rzeczywistych, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności na większą skalę.
- TARGET: dokument, zdanie, aspekt lub stanowisko.
- CONTEXT: domena, mówca, język i czas.
- EVALUATION: błędy per‑klasa i przegląd ludzki.
Najczęściej zadawane pytania
Czy analiza sentymentu jest obiektywna?
Nie. Szacuje etykiety zdefiniowane przez zadanie i proces anotacji. Niektóre teksty są rzeczywiście dwuznaczne, mieszane, zależne od kontekstu lub interpretowane różnie przez czytelników.
Czy analiza sentymentu potrafi wykrywać sarkazm?
Modele mogą nauczyć się niektórych wzorców, ale sarkazm często zależy od historii mówcy, wspólnej wiedzy i kontekstu spoza tekstu. Pozostaje to częstym trybem awaryjnym.
Podstawowe źródła